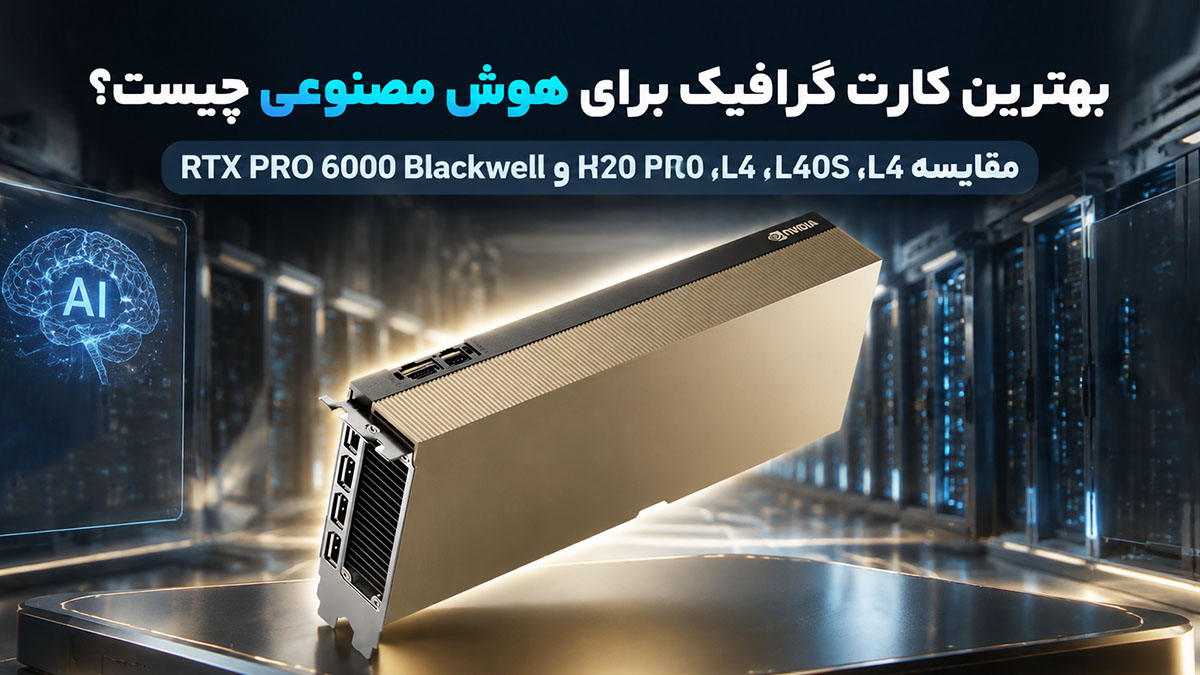
بهترین کارت گرافیک برای هوش مصنوعی چیست؟ مقایسه L4، L40S، H100، H200 و RTX PRO 6000 Blackwell
انتخاب بهترین کارت گرافیک برای سرورهای هوش مصنوعی یکی از مهمترین تصمیمها در طراحی و تجهیز زیرساختهای پردازشی به شمار میرود. مدیران شبکه، متخصصان زیرساخت و کسبوکارهایی که از فناوریهای هوش مصنوعی استفاده میکنند، برای دستیابی به عملکرد مطلوب و بهرهوری بالاتر، نیاز دارند کارت گرافیکی را انتخاب کنند که متناسب با نوع پردازش و نیازهای واقعی سرور باشد.
با توجه به افزایش قابلتوجه هزینه کارتهای گرافیک، انتخاب نادرست میتواند علاوه بر کاهش کارایی سیستم، هزینههای اضافی و غیرضروری به مجموعه تحمیل کند. از طرفی، انتخاب یک کارت گرافیک قدرتمندتر از نیاز واقعی نیز لزوماً به معنای عملکرد بهتر نیست و ممکن است تنها باعث افزایش هزینه خرید، مصرف انرژی و هزینههای نگهداری شود.
به همین دلیل، پیش از خرید کارت گرافیک برای سرورهای هوش مصنوعی، باید مجموعهای از عوامل مانند نوع و حجم پردازش، ظرفیت حافظه گرافیکی (VRAM)، توان پردازشی، پهنای باند حافظه، مصرف انرژی، سازگاری با سرور و بودجه را بهدقت بررسی کرد. در نهایت، بهترین انتخاب کارتی است که بتواند میان عملکرد، هزینه و نیازهای پردازشی سرور تعادل مناسبی ایجاد کند.
اگر برای شما هم این پرسشها مطرح است که:
برای هر نوع سرور هوش مصنوعی و سطح پردازشی، چه کارت گرافیکی مناسبتر است؟
کارت گرافیک استوک انتخاب بهتری است یا مدل نو؟
کارت گرافیک مورد نیاز برای سرورهای هوش مصنوعی را از کجا خریداری کنیم؟
بهترین کارت گرافیک برای پردازشهای هوش مصنوعی کدام است؟
مدلهای مختلف کارت گرافیک چه تفاوتهایی با یکدیگر دارند؟
برترین کارتهای گرافیک موجود در بازار برای کاربردهای هوش مصنوعی کداماند؟
برای خرید کارت گرافیک مناسب، چه میزان بودجهای باید در نظر گرفت؟
در ادامه این مقاله، به بررسی این پرسشها و مهمترین نکاتی میپردازیم که هنگام انتخاب و خرید کارت گرافیک مناسب برای سرورهای هوش مصنوعی باید در نظر داشته باشید. هدف این است که با شناخت بهتر مشخصات فنی و کاربرد هر مدل، بتوانید متناسب با نیاز پردازشی، بودجه و زیرساخت سرور خود، انتخابی دقیق و مقرونبهصرفه داشته باشید.
معرفی بهترین کارت های گرافیک برای هوش مصنوعی
در ابتدا، بهترین کارتهای گرافیک مناسب برای سرورهای هوش مصنوعی را معرفی و بررسی میکنیم. در این بخش، هر یک از مدلهای منتخب را از نظر مشخصات فنی، توان پردازشی، ظرفیت حافظه و کاربردهای مختلف در حوزه هوش مصنوعی مورد بررسی قرار میدهیم تا مشخص شود هر کارت برای چه نوع پردازشها و فعالیتهایی گزینه مناسبتری است.
همچنین، میزان بودجه مورد نیاز برای تهیه هر مدل را بررسی کرده و با مقایسه ویژگیها و قابلیتهای کارتهای گرافیک، به شما کمک میکنیم تا بر اساس نیاز پردازشی و بودجه خود، بهترین گزینه را برای سرور هوش مصنوعی انتخاب کنید.
معرفی کارت گرافیک انویدیا H100
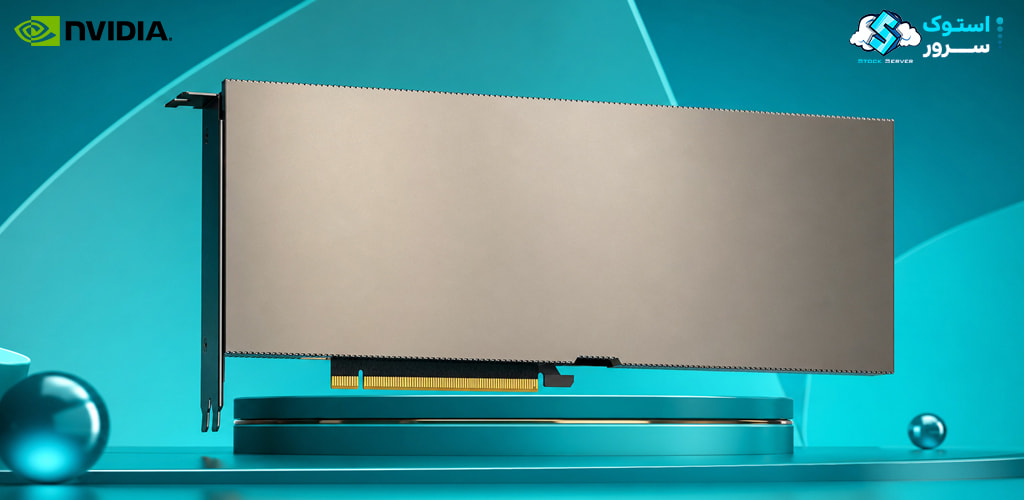
NVIDIA H100 یکی از قدرتمندترین شتابدهندههای پردازشی NVIDIA برای مراکز داده است که بهطور ویژه برای اجرای بارهای کاری سنگین در حوزه هوش مصنوعی و محاسبات با کارایی بالا (HPC) طراحی شده است. این کارت با هدف تأمین توان پردازشی مورد نیاز برای آموزش و اجرای مدلهای پیچیده هوش مصنوعی، بهخصوص مدلهای زبانی بزرگ، توسعه یافته و به یکی از اجزای اصلی زیرساختهای مدرن هوش مصنوعی تبدیل شده است. H100 بر پایه معماری Hopper ساخته شده و در واقع نسل جدیدتر معماری Ampere بهکاررفته در کارتهایی مانند A100 محسوب میشود.
NVIDIA معماری Hopper و کارت گرافیک H100 را در تاریخ ۲۲ مارس ۲۰۲۲ معرفی کرد و نخستین نمونههای این محصول در اکتبر همان سال وارد بازار شدند. نسخه PCIe این کارت نیز در ژوئن ۲۰۲۳ در دسترس قرار گرفت. هدف اصلی از توسعه H100، پاسخ به رشد سریع نیاز به توان پردازشی در آموزش و اجرای مدلهای هوش مصنوعی بود؛ بهویژه در شرایطی که افزایش تعداد پارامترهای مدلهای زبانی بزرگ، به سختافزارهایی با قدرت محاسباتی و پهنای باند بالاتر نیاز داشت.
یکی از مهمترین قابلیتهای H100، استفاده از Transformer Engine است که بهطور اختصاصی برای بهبود عملکرد پردازش مدلهای مبتنی بر ترنسفورمر طراحی شده است. این ویژگی، در کنار توان پردازشی بالای H100، آن را به گزینهای قدرتمند برای آموزش و استنتاج مدلهای پیشرفته هوش مصنوعی تبدیل کرده است. علاوه بر هوش مصنوعی، این شتابدهنده در حوزههایی مانند شبیهسازیهای علمی، تحلیل ژنوم، کشف دارو، پژوهشهای محاسباتی و توسعه رباتیک نیز کاربرد دارد و میتواند زمان مورد نیاز برای انجام محاسبات پیچیده را به میزان قابلتوجهی کاهش دهد.
مشخصات فنی کارت گرافیک NVIDIA H100 80GB
- HPE ProLiant DL380a Gen11
- HPE ProLiant DL385 Gen11
- HPE Apollo 6500 Gen10 Plus
- Other ML Servers, Tower Servers, Workstations
کاربردهای کارت گرافیک NVIDIA H100 80GB در هوش مصنوعی
کارت گرافیک NVIDIA H100 80GB برای طیف گستردهای از پردازشهای پیشرفته طراحی شده و کاربرد اصلی آن در حوزه هوش مصنوعی و یادگیری ماشین است. این کارت به دلیل توان پردازشی بالا و قابلیتهای پیشرفته، برای آموزش و اجرای مدلهای پیچیده هوش مصنوعی و همچنین پردازش حجم زیادی از دادهها مورد استفاده قرار میگیرد.
مهمترین کاربردهای NVIDIA H100 80GB در حوزه هوش مصنوعی عبارتاند از:
• آموزش مدلهای زبانی بزرگ (LLM) مانند GPT، LLaMA و مدلهای مشابه
• تنظیم دقیق مدلهای از پیشآموزشدیده (Fine-tuning) برای کاربردهای تخصصی مانند پزشکی و حقوقی
• اجرای سریع مدلهای هوش مصنوعی و استنتاج (Inference) برای چتباتها، دستیارهای هوشمند و سرویسهای مبتنی بر AI
• یادگیری تقویتی (Reinforcement Learning) برای رباتیک، بازیها و سیستمهای کنترل هوشمند
• یادگیری خودنظارتی (Self-Supervised Learning) برای آموزش مدلها با استفاده از دادههای بدون برچسب
• تولید محتوای هوش مصنوعی، از جمله متن، تصویر، ویدئو و موسیقی
• اجرای مدلهای تولید تصویر و ویدئو مبتنی بر Diffusion
• پردازش زبان طبیعی (NLP)، شامل ترجمه ماشینی، تحلیل احساسات، خلاصهسازی و استخراج اطلاعات
• بینایی ماشین (Computer Vision)، از جمله تشخیص اشیا، تحلیل تصاویر پزشکی و پردازش تصاویر
• آموزش و شبیهسازی سیستمهای رباتیک و خودروهای خودران
علاوه بر کاربردهای هوش مصنوعی، NVIDIA H100 80GB در محاسبات با کارایی بالا (HPC) نیز مورد استفاده قرار میگیرد. از جمله مهمترین این کاربردها میتوان به شبیهسازیهای علمی مانند پیشبینی آبوهوا، بررسی تغییرات اقلیمی، فیزیک پلاسما و دینامیک سیالات اشاره کرد. همچنین در حوزه ژنومیک و زیستشناسی محاسباتی برای توالییابی DNA، تحلیل پروتئینها و پژوهشهای مرتبط با کشف دارو کاربرد دارد. پردازش گرافهای بزرگ، شیمی محاسباتی، شبیهسازی برهمکنشهای مولکولی و طراحی مواد جدید نیز از دیگر کاربردهای H100 در این حوزه هستند.
در زیرساخت مراکز داده و رایانش ابری نیز از H100 برای ایجاد خوشههای پردازشی بزرگ و زیرساختهای موسوم به «کارخانههای هوش مصنوعی» استفاده میشود. فناوریهایی مانند NVLink و InfiniBand امکان اتصال تعداد زیادی GPU را برای اجرای پردازشهای توزیعشده فراهم میکنند و قابلیت MIG نیز اجازه میدهد منابع GPU برای اجرای همزمان چندین بار کاری تقسیم شوند. همچنین قابلیت Confidential Computing، امکان استفاده از این شتابدهنده را در پردازش دادهها و مدلهای حساس فراهم میکند.
در حوزه صنعت و کسبوکار نیز H100 در سیستمهای توصیهگر، تحلیل کلانداده، پردازش زبان طبیعی، بینایی ماشین و رباتیک پیشرفته کاربرد دارد. در کنار این موارد، تولید محتوای مبتنی بر هوش مصنوعی (AIGC)، رندرینگ سهبعدی و پردازشهای مرتبط با واقعیت مجازی نیز از دیگر زمینههایی هستند که میتوان از توان پردازشی بالای NVIDIA H100 80GB در آنها بهره گرفت.

معرفی کارت گرافیک انویدیا H200
کارت گرافیک NVIDIA H200 یکی از قدرتمندترین شتابدهندههای محاسباتی مبتنی بر معماری NVIDIA Hopper است که با تمرکز بر پردازشهای سنگین هوش مصنوعی، یادگیری عمیق، مدلهای زبانی بزرگ (LLM) و محاسبات علمی (HPC) طراحی شده است. این کارت با بهرهگیری از 141 گیگابایت حافظه HBM3e و پهنای باند حافظه بسیار بالا، امکان پردازش سریع حجم عظیمی از داده را فراهم میکند و برای زیرساختهای دیتاسنتری و سرورهای محاسباتی پیشرفته گزینهای مناسب محسوب میشود.
یکی از مهمترین نقاط قوت NVIDIA H200، حافظه HBM3e با ظرفیت 141GB و پهنای باند 4.8TB/s است که نسبت به نسل قبل، یعنی H100، ظرفیت حافظه و سرعت دسترسی به داده را افزایش داده است. این ویژگی بهخصوص در اجرای مدلهای هوش مصنوعی بزرگ، پردازش دادههای حجیم و بارهای کاری حساس به پهنای باند حافظه اهمیت زیادی دارد.
NVIDIA H200 به 16,896 هسته CUDA مجهز شده و از نسل جدید Tensor Coreها و فناوری Transformer Engine بهره میبرد. این مجموعه برای تسریع عملیات مربوط به هوش مصنوعی و مدلهای ترنسفورمری طراحی شده و از دقتهای مختلف محاسباتی مانند FP64، FP32، TF32، BF16 و FP8 پشتیبانی میکند. در نتیجه، H200 میتواند در مراحل مختلف آموزش و استنتاج مدلهای هوش مصنوعی، از پردازش مدلهای زبانی گرفته تا تحلیل دادههای پیچیده، نقش یک شتابدهنده قدرتمند را ایفا کند.
این کارت همچنین از NVLink نسل چهارم با پهنای باند بالا برای ارتباط میان چند GPU پشتیبانی میکند. این قابلیت در سرورهایی که به چند شتابدهنده گرافیکی مجهز هستند، امکان تبادل سریع داده میان GPUها را فراهم کرده و برای اجرای بارهای کاری توزیعشده و مدلهای بسیار بزرگ اهمیت ویژهای دارد. پشتیبانی از Multi-Instance GPU (MIG) نیز امکان تقسیم منابع GPU به چند نمونه مستقل را برای استفاده بهینهتر از سختافزار فراهم میکند.
NVIDIA H200 در دو فرمفاکتور اصلی H200 SXM و H200 NVL ارائه شده است که از نظر توان مصرفی و برخی مشخصات عملکردی با یکدیگر تفاوت دارند. نسخه SXM با توان بالاتر برای بیشینهسازی عملکرد در زیرساختهای دیتاسنتری طراحی شده، در حالی که نسخه NVL گزینهای مناسب برای پیکربندیهای سروری با محدودیتهای متفاوت در مصرف توان و فضای نصب است.
در مجموع، NVIDIA H200 یک شتابدهنده تخصصی برای مراکز داده و زیرساختهای محاسباتی پیشرفته است که ترکیب ظرفیت بالای حافظه HBM3e، پهنای باند بسیار زیاد، هستههای CUDA و Tensor Core قدرتمند و قابلیتهای ارتباطی پیشرفته را در اختیار سازمانهایی قرار میدهد که با بارهای کاری سنگین هوش مصنوعی و محاسبات علمی سروکار دارند.
مشخصات فنی کارت گرافیک NVIDIA H200 141GB
کاربردهای کارت گرافیک NVIDIA H200 141GB در هوش مصنوعی
کارت گرافیک NVIDIA H200 برای پردازشهای سنگین محاسباتی و بهویژه کاربردهای مرتبط با هوش مصنوعی، یادگیری ماشین و یادگیری عمیق طراحی شده است. حافظه 141 گیگابایتی HBM3e با پهنای باند 4.8 ترابایت بر ثانیه، امکان پردازش سریع حجم بالایی از داده و اجرای مدلهای بزرگ هوش مصنوعی را فراهم میکند. این ویژگی باعث شده H200 در آموزش و استنتاج مدلهای زبانی بزرگ، پردازش دادههای حجیم و زیرساختهای پیشرفته هوش مصنوعی مورد استفاده قرار گیرد.
این شتابدهنده همچنین برای محاسبات علمی و فنی (HPC)، شبیهسازیهای پیچیده، تحلیل دادههای گسترده و پردازشهای چند GPU کاربرد دارد. پشتیبانی از Tensor Core، Transformer Engine و NVLink امکان استفاده از توان محاسباتی چندین GPU بهصورت همزمان را فراهم کرده و H200 را به گزینهای مناسب برای دیتاسنترها، مراکز تحقیقاتی و زیرساختهای محاسباتی پیشرفته تبدیل میکند.
مهمترین کاربردهای NVIDIA H200 :
آموزش مدلهای هوش مصنوعی و یادگیری عمیق
آموزش و اجرای مدلهای زبانی بزرگ (LLM)
استنتاج (Inference) مدلهای هوش مصنوعی
پردازش و تحلیل حجم بالای دادهها
محاسبات علمی و High Performance Computing (HPC)
شبیهسازیهای علمی و مهندسی
تحقیقات ژنومیک و زیستمحاسباتی
شبیهسازی و بهینهسازی فرآیندهای صنعتی
پردازشهای سنگین در دیتاسنترها
پردازشهای چند GPU و محاسبات توزیعشده
زیرساختهای ابری و سرورهای هوش مصنوعی
تحقیقات دانشگاهی و پروژههای محاسباتی پیشرفته
در مجموع، NVIDIA H200 با ترکیب توان پردازشی بالا، حافظه HBM3e با ظرفیت 141 گیگابایت و پهنای باند 4.8 ترابایت بر ثانیه، برای اجرای بارهای کاری سنگین و پردازشهای دادهمحور طراحی شده است. این کارت میتواند در طیف گستردهای از پروژههای هوش مصنوعی، محاسبات علمی، تحلیل داده و زیرساختهای دیتاسنتری مورد استفاده قرار گیرد و بهویژه برای محیطهایی مناسب است که به ظرفیت حافظه بالا و توان پردازشی قابل توجه نیاز دارند.
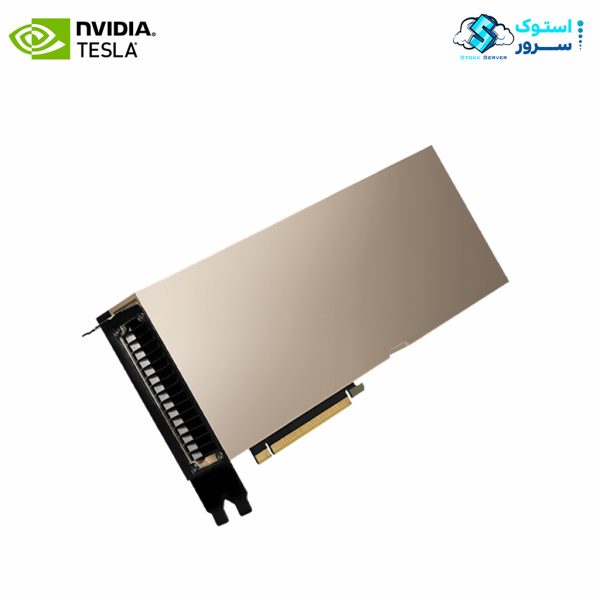
معرفی کارت گرافیک انویدیا L40S
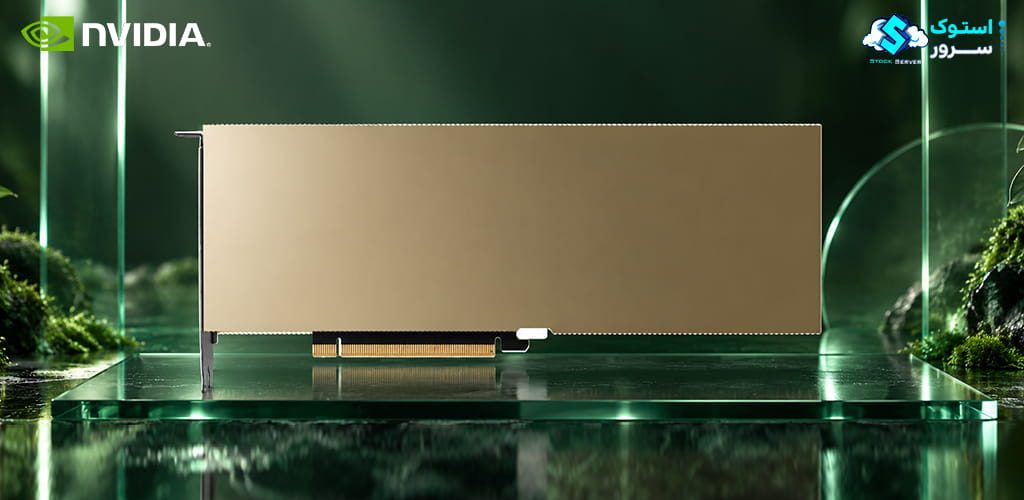
کارت گرافیک NVIDIA L40S یک شتابدهنده حرفهای دیتاسنتری است که بر پایه معماری NVIDIA Ada Lovelace طراحی شده و برای طیف گستردهای از پردازشهای هوش مصنوعی، یادگیری ماشین، رندرینگ و پردازش گرافیکی مورد استفاده قرار میگیرد. این کارت با 48 گیگابایت حافظه GDDR6 مجهز به ECC، پهنای باند حافظه 864GB/s و 18,176 هسته CUDA، توان پردازشی بالایی را برای اجرای بارهای کاری حرفهای فراهم میکند.
L40S علاوه بر هستههای CUDA، به 568 هسته Tensor نسل چهارم و 142 هسته RT نسل سوم مجهز شده است. این ترکیب باعث میشود کارت در اجرای مدلهای هوش مصنوعی، استنتاج مدلهای زبانی، پردازشهای یادگیری عمیق و همچنین رندرینگ سهبعدی و شبیهسازی عملکرد مناسبی داشته باشد. پشتیبانی از قابلیتهای پیشرفته معماری Ada Lovelace نیز امکان استفاده از این کارت را در پروژههای متنوع محاسباتی و گرافیکی فراهم میکند.
از دیگر قابلیتهای NVIDIA L40S میتوان به پشتیبانی از vGPU، پردازش ویدیو و فناوریهای Encode و Decode از جمله AV1 اشاره کرد. به همین دلیل این کارت در زیرساختهای مجازیسازی، ایستگاههای کاری مجازی، تولید محتوای دیجیتال، پردازش ویدیو و محیطهای سهبعدی مانند NVIDIA Omniverse نیز کاربرد دارد.
در مجموع، NVIDIA L40S یک GPU چندمنظوره برای دیتاسنترها است که توان پردازش هوش مصنوعی را با قابلیتهای گرافیکی و رندرینگ ترکیب میکند. این کارت برای سازمانها و زیرساختهایی مناسب است که به یک شتابدهنده قدرتمند برای اجرای همزمان بارهای کاری AI، گرافیکی و پردازش رسانه نیاز دارند.
برای تغییر این متن بر روی دکمه ویرایش کلیک کنید. لورم ایپسوم متن ساختگی با تولید سادگی نامفهوم از صنعت چاپ و با استفاده از طراحان گرافیک است.
مشخصات فنی کارت گرافیک NVIDIA L40S 48GB
کاربردهای کارت گرافیک NVIDIA L40S 48GB در هوش مصنوعی
کارت گرافیک NVIDIA L40S 48GB با معماری Ada Lovelace و بهرهگیری از 18,176 هسته CUDA و 568 هسته Tensor نسل چهارم، برای اجرای طیف گستردهای از پردازشهای هوش مصنوعی طراحی شده است. حافظه 48 گیگابایتی GDDR6 ECC و پهنای باند 864GB/s نیز امکان اجرای مدلهای هوش مصنوعی و پردازش حجم بالایی از داده را فراهم میکند.
L40S در آموزش و Fine-Tuning مدلهای هوش مصنوعی، اجرای مدلهای زبانی و استنتاج (Inference) کاربرد دارد. این کارت برای مدلهای زبانی کوچک و متوسط، مدلهای بینایی ماشین، پردازش زبان طبیعی و سایر پروژههای یادگیری عمیق گزینهای مناسب محسوب میشود و میتواند در زیرساختهای دیتاسنتری برای اجرای همزمان چندین بار کاری مورد استفاده قرار گیرد.
از طرف دیگر، قابلیتهای گرافیکی L40S باعث شده این کارت تنها به پردازش AI محدود نباشد و در محیطهایی که هوش مصنوعی در کنار رندرینگ و پردازشهای گرافیکی استفاده میشود نیز کاربرد داشته باشد. پشتیبانی از vGPU، هستههای RT و قابلیتهای پردازش ویدیو، امکان استفاده از L40S را در زیرساختهای مجازیسازی، ایستگاههای کاری مجازی و محیطهای تولید محتوای حرفهای فراهم میکند.
مهمترین کاربردهای NVIDIA L40S در هوش مصنوعی:
- آموزش و Fine-Tuning مدلهای هوش مصنوعی
- اجرای مدلهای زبانی کوچک و متوسط (LLM و SLM)
- استنتاج سریع مدلهای هوش مصنوعی (AI Inference)
- پردازش زبان طبیعی (NLP)
- بینایی ماشین و تحلیل تصاویر و ویدیو
- یادگیری عمیق (Deep Learning)
- اجرای مدلهای Generative AI
- پردازش و تحلیل حجم بالای داده
- اجرای همزمان چندین سرویس و مدل AI در دیتاسنتر
- مجازیسازی منابع GPU با استفاده از NVIDIA vGPU
- توسعه و اجرای برنامههای هوش مصنوعی در محیطهای ابری و دیتاسنتری
- استفاده در NVIDIA Omniverse و پروژههای ترکیبی AI و گرافیک
- پردازش ویدیو و کاربردهای مبتنی بر AV1 Encode/Decode
برای جمعبندی، NVIDIA L40S 48GB را میتوان یک شتابدهنده چندمنظوره برای زیرساختهای مدرن هوش مصنوعی دانست که توان پردازشی مناسب، حافظه 48 گیگابایتی و قابلیتهای پیشرفته معماری Ada Lovelace را در اختیار کاربران قرار میدهد. این کارت با پشتیبانی از آموزش و استنتاج مدلهای AI، یادگیری عمیق، پردازش گرافیکی و مجازیسازی، انتخابی کاربردی برای دیتاسنترها و سازمانهایی است که به یک GPU قدرتمند برای اجرای طیف متنوعی از بارهای کاری نیاز دارند.

معرفی کارت گرافیک انویدیا L4
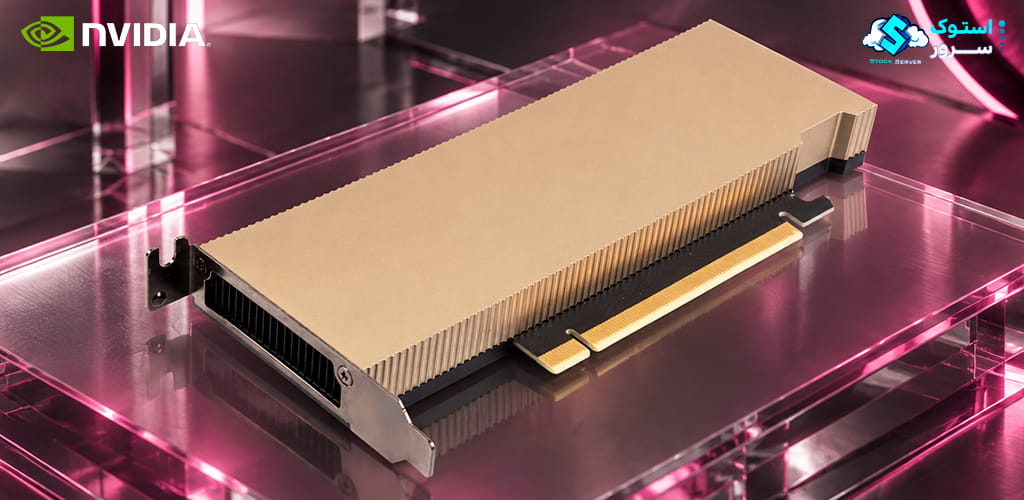
کارت گرافیک NVIDIA L4 24GB یک GPU حرفهای دیتاسنتری بر پایه معماری NVIDIA Ada Lovelace است که با تمرکز بر مصرف انرژی پایین، عملکرد مناسب و قابلیت استقرار در مقیاس بالا طراحی شده است. این کارت به 24 گیگابایت حافظه GDDR6 مجهز به ECC، پهنای باند حافظه 300GB/s و 7,424 هسته CUDA مجهز شده و برای اجرای بارهای کاری هوش مصنوعی، استنتاج مدلها و پردازش ویدیو مورد استفاده قرار میگیرد.
یکی از مهمترین ویژگیهای NVIDIA L4، توان مصرفی بسیار پایین 72 وات و طراحی تکاسلات Low-Profile آن است. این ویژگی امکان استفاده از L4 را در سرورهایی با محدودیت فضا و توان فراهم میکند و باعث میشود بتوان تعداد بیشتری از این GPUها را در زیرساختهای دیتاسنتری مستقر کرد. L4 همچنین بدون نیاز به کابل برق اضافی کار میکند و برای محیطهایی که بهرهوری انرژی اهمیت بالایی دارد، گزینهای کاربردی محسوب میشود.
NVIDIA L4 بهطور ویژه برای Inference و پردازشهای هوش مصنوعی در مقیاس بالا، تولید محتوا و پردازش ویدیو طراحی شده است. پشتیبانی از قابلیتهای معماری Ada Lovelace و هستههای Tensor، در کنار موتورهای اختصاصی Encode و Decode و پشتیبانی از AV1، این کارت را برای کاربردهایی مانند استنتاج مدلهای زبانی، تولید تصویر، بینایی ماشین، استریم ویدیو و پردازش رسانه مناسب میکند.
در مجموع، NVIDIA L4 24GB یک شتابدهنده کممصرف و همهکاره برای دیتاسنترها است که بهجای تمرکز بر حداکثر توان پردازشی، بر ترکیب بهرهوری انرژی، قابلیت استقرار گسترده و عملکرد مناسب در استنتاج و پردازش ویدیو تمرکز دارد.
مشخصات فنی کارت گرافیک NVIDIA L4 24GB
کاربردهای کارت گرافیک NVIDIA L4 24GB در هوش مصنوعی
کارت گرافیک NVIDIA L4 24GB یکی از GPUهای کممصرف دیتاسنتری است که تمرکز اصلی آن بر اجرای Inference و پردازش مدلهای هوش مصنوعی در مقیاس بالا قرار دارد. این کارت با 24 گیگابایت حافظه GDDR6 ECC، هستههای CUDA و Tensor و معماری Ada Lovelace، امکان اجرای مدلهای مختلف یادگیری عمیق و هوش مصنوعی را با مصرف انرژی پایین فراهم میکند. به همین دلیل L4 برای سرویسهایی که باید بهصورت مداوم و همزمان به تعداد زیادی درخواست پاسخ دهند، کاربرد زیادی دارد.
در حوزه مدلهای زبانی و Generative AI، از NVIDIA L4 میتوان برای اجرای مدلهای زبانی کوچک و متوسط، پردازش زبان طبیعی و استنتاج مدلهای تولیدکننده محتوا استفاده کرد. حافظه 24 گیگابایتی این کارت برای بسیاری از مدلهای سبک و متوسط مناسب است و مصرف انرژی پایین آن امکان استفاده از چندین GPU در یک زیرساخت را بدون افزایش شدید مصرف برق فراهم میکند. L4 همچنین برای کاربردهایی مانند بینایی ماشین، تشخیص اشیا و تحلیل تصاویر و ویدیو قابل استفاده است.
یکی دیگر از کاربردهای مهم L4، ترکیب هوش مصنوعی و پردازش ویدیو است. موتورهای اختصاصی Encode و Decode و پشتیبانی از AV1، این GPU را برای سرویسهایی که همزمان به تحلیل و پردازش حجم بالایی از محتوای ویدیویی نیاز دارند، مناسب میکند. در نتیجه میتوان از L4 در سرویسهای ویدیویی هوشمند، سیستمهای نظارت تصویری، تحلیل ویدیو، پردازش رسانه و زیرساختهای AI در دیتاسنتر و Edge استفاده کرد.
مهمترین کاربردهای NVIDIA L4 در هوش مصنوعی:
- استنتاج مدلهای هوش مصنوعی (AI Inference)
- اجرای مدلهای زبانی کوچک و متوسط
- اجرای مدلهای Generative AI
- پردازش زبان طبیعی (NLP)
- بینایی ماشین (Computer Vision)
- تشخیص و شناسایی اشیا در تصاویر و ویدیو
- تحلیل ویدیو با استفاده از هوش مصنوعی
- پردازش و دستهبندی تصاویر
- اجرای مدلهای یادگیری عمیق
- پردازش ویدیو در سرویسهای هوشمند
- سیستمهای نظارت تصویری مبتنی بر AI
- پردازش همزمان تعداد زیادی درخواست Inference
- استفاده در زیرساختهای Edge AI
- سرویسهای هوش مصنوعی ابری و دیتاسنتری
- پردازش رسانه و محتوای ویدیویی مبتنی بر AI
- استفاده در برنامههای AI با اولویت مصرف انرژی پایین
در مجموع، NVIDIA L4 24GB یک شتابدهنده کممصرف و کاربردی برای اجرای طیف گستردهای از بارهای کاری هوش مصنوعی است که تمرکز ویژهای بر Inference، پردازش ویدیو و سرویسهای AI در مقیاس بالا دارد. مصرف انرژی پایین، فرمفاکتور کمحجم و پشتیبانی از قابلیتهای پیشرفته پردازش ویدیو، این کارت را برای دیتاسنترها، زیرساختهای Edge و سرویسهایی که به اجرای مداوم مدلهای هوش مصنوعی با هزینه عملیاتی پایین نیاز دارند، مناسب میکند.
معرفی کارت گرافیک انویدیا RTX PRO 6000 Blackwell
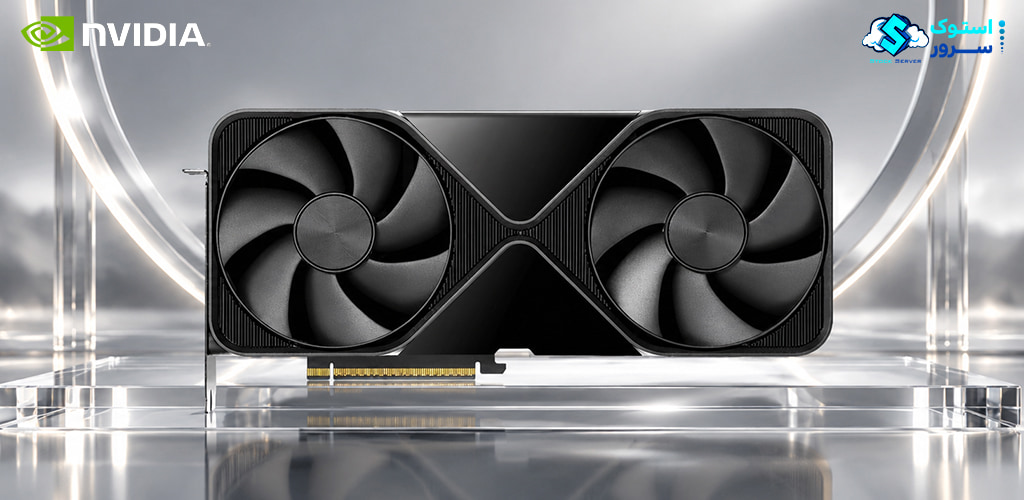
کارت گرافیک NVIDIA RTX PRO 6000 Blackwell یک GPU حرفهای و قدرتمند برای ایستگاههای کاری و زیرساختهای سروری است که بر پایه معماری NVIDIA Blackwell طراحی شده است. این کارت با 96 گیگابایت حافظه GDDR7 مجهز به ECC، پهنای باند حافظه بالا و 24,064 هسته CUDA، توان پردازشی قابل توجهی را برای اجرای طیف گستردهای از بارهای کاری حرفهای فراهم میکند.
یکی از مهمترین ویژگیهای RTX PRO 6000، ترکیب توان پردازشی بالا با حافظه گرافیکی 96GB است. این حجم حافظه امکان اجرای مدلهای پیچیده هوش مصنوعی، Fine-tuning مدلهای بزرگ، شبیهسازیهای علمی و پروژههای گرافیکی سنگین را فراهم میکند. پشتیبانی از قابلیتهای پیشرفته معماری Blackwell و Tensor Core نیز باعث شده این کارت در پردازشهای AI و استنتاج مدلهای هوش مصنوعی عملکرد بالایی داشته باشد.
RTX PRO 6000 علاوه بر هوش مصنوعی، برای رندرینگ سهبعدی، طراحی مهندسی، شبیهسازی، تولید محتوای حرفهای و ایستگاههای کاری مجازی نیز طراحی شده است. پشتیبانی از فناوریهای حرفهای NVIDIA و قابلیت استفاده در محیطهای Workstation و Server باعث میشود این کارت بتواند بارهای کاری گرافیکی و محاسباتی متنوعی را در یک پلتفرم واحد اجرا کند.
این کارت در نسخههای Server Edition، Workstation Edition و Max-Q Workstation عرضه میشود که هرکدام با توجه به توان مصرفی، سیستم خنککننده و فرمفاکتور برای محیط متفاوتی طراحی شدهاند. در نتیجه، NVIDIA RTX PRO 6000 Blackwell را میتوان یک GPU حرفهای همهکاره دانست که قدرت پردازشی بالا، حافظه بسیار حجیم و قابلیتهای پیشرفته گرافیکی و هوش مصنوعی را برای پروژههای حرفهای و زیرساختهای محاسباتی فراهم میکند.
مشخصات فنی کارت گرافیک RTX PRO 6000 Blackwell
کاربردهای کارت گرافیک RTX PRO 6000 Blackwell در هوش مصنوعی
کارت گرافیک NVIDIA RTX PRO 6000 Blackwell با بهرهگیری از معماری Blackwell، تعداد 24,064 هسته CUDA و 96 گیگابایت حافظه GDDR7 ECC، برای اجرای طیف گستردهای از پردازشهای هوش مصنوعی و یادگیری عمیق طراحی شده است. ظرفیت بالای حافظه این کارت امکان اجرای مدلهای بزرگ هوش مصنوعی و پردازش دادههای حجیم را فراهم میکند و در پروژههایی که محدودیت حافظه GPU اهمیت دارد، مزیت قابل توجهی ایجاد میکند.
یکی از مهمترین کاربردهای RTX PRO 6000 Blackwell، آموزش و Fine-Tuning مدلهای هوش مصنوعی و مدلهای زبانی بزرگ (LLM) است. حجم 96 گیگابایتی حافظه GPU امکان اجرای مدلهای بزرگتر را روی یک کارت فراهم میکند و Tensor Coreهای معماری Blackwell نیز برای پردازشهای هوش مصنوعی با دقتهای مختلف، از جمله FP4، عملکرد بالایی ارائه میدهند. به همین دلیل این GPU میتواند در توسعه مدلهای مولد، پردازش زبان طبیعی و استنتاج مدلهای پیچیده مورد استفاده قرار گیرد.
این کارت در Generative AI، بینایی ماشین، پردازش تصویر و ویدیو نیز کاربرد دارد. توان پردازشی بالای RTX PRO 6000 باعث میشود بتوان از آن برای آموزش و اجرای مدلهای Computer Vision، تشخیص اشیا، تحلیل تصاویر، پردازش ویدیو و تولید محتوای مبتنی بر هوش مصنوعی استفاده کرد. همچنین حافظه حجیم آن برای پروژههایی که با دادههای تصویری و مدلهای سنگین سروکار دارند، فضای مناسبی در اختیار سیستم قرار میدهد.
از دیگر قابلیتهای مهم این GPU میتوان به امکان استفاده در Workstation و Data Center و پشتیبانی از قابلیتهای مجازیسازی اشاره کرد. فناوری MIG امکان تقسیم منابع GPU به چند Instance مستقل را فراهم میکند و در نتیجه میتوان از RTX PRO 6000 برای اجرای همزمان چند سرویس یا بار کاری مختلف استفاده کرد.
مهمترین کاربردهای RTX PRO 6000 Blackwell در هوش مصنوعی:
آموزش و Fine-Tuning مدلهای هوش مصنوعی
اجرای مدلهای زبانی بزرگ (LLM)
Inference و استنتاج مدلهای AI
Generative AI و تولید محتوای هوش مصنوعی
پردازش زبان طبیعی (NLP)
بینایی ماشین (Computer Vision)
تشخیص و طبقهبندی اشیا و تصاویر
پردازش و تحلیل ویدیو
توسعه مدلهای یادگیری عمیق (Deep Learning)
پردازش دادههای حجیم و محاسبات شتابیافته
شبیهسازیهای علمی و مهندسی
اجرای همزمان چند بار کاری با استفاده از MIG
زیرساختهای هوش مصنوعی در دیتاسنترها و Workstationهای حرفهای
در مجموع، NVIDIA RTX PRO 6000 Blackwell یک GPU حرفهای همهکاره است که توان پردازشی بالای معماری Blackwell را با 96GB حافظه GDDR7 ECC ترکیب میکند. این ویژگیها باعث میشوند کارت برای آموزش و Fine-Tuning مدلهای بزرگ، استنتاج، Generative AI، پردازش تصویر و ویدیو و محاسبات حرفهای گزینهای مناسب باشد. در کنار کاربردهای هوش مصنوعی، قابلیت استفاده در رندرینگ، شبیهسازی و محیطهای Workstation و Server نیز باعث شده RTX PRO 6000 Blackwell تنها یک شتابدهنده AI نباشد و بتواند بهعنوان یک GPU حرفهای چندمنظوره برای بارهای کاری سنگین مورد استفاده قرار گیرد.

مقایسه کارتهای گرافیک NVIDIA برای هوش مصنوعی
در جدول زیر پنج GPU حرفهای NVIDIA شامل L4، L40S، H100، H200 و RTX PRO 6000 Blackwell از نظر معماری، حافظه، پهنای باند، توان مصرفی و کاربرد اصلی با یکدیگر مقایسه شدهاند.
| GPU | معماری | حافظه | پهنای باند | TDP | کاربرد اصلی |
|---|---|---|---|---|---|
| NVIDIA L4 | Ada Lovelace | 24GB GDDR6 | 300 GB/s | 72W | استنتاج، ویدیو، Edge AI |
| NVIDIA L40S | Ada Lovelace | 48GB GDDR6 | 864 GB/s | 350W | استنتاج، رندر، گرافیک |
| NVIDIA H100 | Hopper | 80GB HBM3 | 3.35 TB/s | 700W | آموزش LLM، HPC |
| NVIDIA H200 | Hopper | 141GB HBM3e | 4.8 TB/s | 700W | LLM بزرگ، Inference، RAG |
| RTX PRO 6000 | Blackwell | 96GB GDDR7 | 1.6 TB/s | 300–600W | Agentic AI، LLM، گرافیک حرفهای |
ویژگیها و کاربرد هر GPU
NVIDIA L4
- کارت Single-Slot با توان مصرفی تنها 72 وات
- توان FP8 Tensor حدود 485 TFLOPS با Sparsity
- مناسب برای Inference، RAG و پردازش ویدیو
- پشتیبانی از AV1 برای پردازش و ترنسکد ویدیو
- مناسب برای استقرار در Edge و دیتاسنترهای پرتراکم
- برای آموزش مدلهای بسیار بزرگ انتخاب مناسبی نیست
NVIDIA L40S
- مجهز به 18,176 هسته CUDA
- دارای 568 هسته Tensor و 142 هسته RT
- توان FP8 Tensor حدود 733 TFLOPS با Sparsity
- مناسب برای Generative AI و LLMهای متوسط
- کاربرد در رندر سهبعدی، VDI و پردازش گرافیکی
- 48GB حافظه GDDR6 برای بارهای کاری متنوع
NVIDIA H100
- مبتنی بر معماری NVIDIA Hopper
- پشتیبانی از NVLink با سرعت 900 GB/s
- مجهز به Transformer Engine و FP8
- پشتیبانی از 7 MIG Instance
- مناسب برای آموزش LLM و Fine-Tuning
- کاربرد گسترده در HPC و شبیهسازیهای علمی
NVIDIA H200
- نسخه ارتقایافته H100 بر پایه معماری Hopper
- مجهز به 141GB حافظه HBM3e
- پهنای باند بسیار بالای 4.8 TB/s
- مناسب برای LLMهای بزرگ و بارهای کاری Memory-Bound
- کاربرد در RAG و پایگاههای داده برداری بزرگ
- مناسب برای استنتاج مدلهای بزرگ هوش مصنوعی
NVIDIA RTX PRO 6000 Blackwell
- مبتنی بر معماری جدید NVIDIA Blackwell
- مجهز به 96GB GDDR7 ECC
- دارای 24,064 هسته CUDA و 752 هسته Tensor
- پشتیبانی از FP4 برای پردازشهای نسل جدید AI
- پشتیبانی از MIG تا 4 Instance
- مناسب برای Agentic AI، LLMهای لوکال، دادهکاوی و رندر حرفهای
نکات کلیدی مقایسه
ظرفیت حافظه: H200 با 141GB بیشترین ظرفیت حافظه را دارد و پس از آن RTX PRO 6000 با 96GB، H100 با 80GB، L40S با 48GB و L4 با 24GB قرار میگیرند.
پهنای باند حافظه: H200 با 4.8TB/s و H100 با 3.35TB/s پهنای باند بسیار بالایی ارائه میکنند. RTX PRO 6000 نیز با حدود 1.6TB/s در رده بالاتری از L40S و L4 قرار میگیرد.
معماری: H100 و H200 بر پایه Hopper، مدلهای L4 و L40S بر پایه Ada Lovelace و RTX PRO 6000 بر پایه معماری جدیدتر Blackwell طراحی شدهاند.
نوع کاربرد: H100 و H200 برای بارهای کاری سنگین AI و HPC، L4 و L40S برای Inference و کاربردهای گرافیکی، و RTX PRO 6000 برای ترکیب AI، LLM و پردازشهای حرفهای گرافیکی کاربرد دارند.
جمعبندی مقایسه GPUها
انتخاب بین این پنج GPU به نوع بار کاری، حجم مدل، نیاز به حافظه و توان پردازشی بستگی دارد. L4 با مصرف 72 وات برای Inference، پردازش ویدیو و محیطهای پرتراکم طراحی شده، در حالی که L40S ترکیبی از قابلیتهای هوش مصنوعی و گرافیکی را ارائه میدهد. H100 و H200 با استفاده از حافظه HBM و پهنای باند بسیار بالا، برای مدلهای بزرگ، آموزش، استنتاج سنگین و محاسبات HPC مناسب هستند. در مقابل، RTX PRO 6000 Blackwell با 96GB حافظه GDDR7، معماری Blackwell، پشتیبانی از FP4 و قابلیتهای حرفهای گرافیکی، گزینهای چندمنظوره برای هوش مصنوعی، LLM، Agentic AI و Workstationهای حرفهای محسوب میشود.
کدام GPU برای کسبوکار شما مناسب است؟
انتخاب کارت گرافیک فقط به میزان قدرت پردازشی بستگی ندارد. نوع کسبوکار، حجم مدلهای هوش مصنوعی، نیاز به رندرینگ، میزان مصرف انرژی و نوع بار کاری نیز در انتخاب GPU مناسب اهمیت دارد.
NVIDIA L4
کممصرفاگر کسبوکار شما به اجرای مداوم مدلهای هوش مصنوعی، استنتاج، پردازش تصویر یا ویدیو نیاز دارد اما مصرف انرژی و تراکم سرور برایتان مهم است، L4 گزینهای کاربردی است. توان مصرفی پایین این GPU امکان استفاده از تعداد بیشتری کارت در زیرساختهای پرتراکم را فراهم میکند.
NVIDIA L40S
همهکارهL40S برای کسبوکارهایی مناسب است که همزمان به توان پردازش هوش مصنوعی و قابلیتهای گرافیکی حرفهای نیاز دارند. این GPU میتواند در استنتاج مدلهای AI، رندر سهبعدی، ایستگاههای کاری مجازی و تولید محتوای حرفهای استفاده شود.
NVIDIA H100
AI حرفهایH100 برای کسبوکارهایی طراحی شده که بخش اصلی زیرساخت آنها بر آموزش، Fine-Tuning و اجرای مدلهای بزرگ هوش مصنوعی متمرکز است. قابلیتهایی مانند Transformer Engine و NVLink امکان استفاده از چند GPU در پروژههای محاسباتی بزرگ را فراهم میکنند.
NVIDIA H200
حافظه بالاH200 برای کسبوکارهایی مناسب است که مدلهای بسیار بزرگ و بارهای کاری وابسته به حافظه دارند. حافظه 141GB HBM3e و پهنای باند 4.8TB/s امکان پردازش مدلها و مجموعه دادههای حجیم را در کاربردهایی مانند LLM و RAG فراهم میکند.
NVIDIA RTX PRO 6000 Blackwell
BlackwellRTX PRO 6000 Blackwell برای کسبوکارهایی مناسب است که میخواهند هوش مصنوعی و پردازش گرافیکی حرفهای را در یک GPU قدرتمند ترکیب کنند. حافظه 96GB GDDR7، معماری Blackwell و پشتیبانی از FP4 آن را برای LLM، Agentic AI، تولید محتوا، رندرینگ و پردازشهای حرفهای مناسب میکند.
انتخاب GPU بر اساس نوع کسبوکار
اگر اولویت شما مصرف انرژی پایین و Inference است، L4 برای این نوع زیرساخت طراحی شده است. برای کسبوکارهایی که ترکیبی از هوش مصنوعی و پردازش گرافیکی دارند، L40S میتواند در هر دو حوزه مورد استفاده قرار گیرد. در پروژههایی که تمرکز اصلی روی آموزش و توسعه مدلهای بزرگ AI است، H100 و H200 برای بارهای کاری محاسباتی و حافظهمحور طراحی شدهاند. در نهایت، RTX PRO 6000 Blackwell برای محیطهایی که بهطور همزمان به AI، مدلهای زبانی، پردازش گرافیکی و Workstation حرفهای نیاز دارند، ترکیبی از این قابلیتها را ارائه میدهد.
کانفیگ پیشنهادی سرور HPE برای هر GPU
انتخاب GPU تنها بخشی از طراحی یک سرور هوش مصنوعی است. پردازنده، حافظه RAM، منبع تغذیه، فضای ذخیرهسازی و ظرفیت توسعه سرور نیز باید متناسب با توان و نوع استفاده از GPU انتخاب شوند. در ادامه چند کانفیگ پیشنهادی برای استفاده از GPUهای مختلف در سرورهای HPE آورده شده است.
HPE ProLiant DL380 Gen10
مناسب برای: AI Inference، پردازش ویدیو، RAG و سرویسهای Edge AI
کانفیگ پیشنهادی
چرا این کانفیگ؟
L4 مصرف انرژی پایینی دارد و امکان استفاده از چند GPU در یک سرور را فراهم میکند. DL380 Gen10 برای این نوع بار کاری، فضای توسعه و انعطاف مناسبی ارائه میدهد.
Low Power AIHPE ProLiant DL380 Gen10
مناسب برای: Generative AI، رندرینگ، VDI و پردازش گرافیکی
کانفیگ پیشنهادی
چرا این کانفیگ؟
L40S علاوه بر AI برای پردازشهای گرافیکی سنگین نیز کاربرد دارد. بنابراین CPU، RAM و شبکه بالاتر برای استفاده همزمان از AI، رندرینگ و VDI در نظر گرفته شده است.
AI + GraphicsHPE ProLiant DL380 Gen11
مناسب برای: آموزش LLM، Fine-Tuning، Deep Learning و HPC
کانفیگ پیشنهادی
چرا این کانفیگ؟
H100 برای بارهای کاری سنگین AI طراحی شده است. بنابراین حافظه سیستم، سرعت ذخیرهسازی و شبکه باید بتوانند داده را با سرعت مناسب در اختیار GPU قرار دهند.
AI TrainingHPE ProLiant DL380 Gen11
مناسب برای: LLMهای بزرگ، RAG، Inference و پردازش دادههای حجیم
کانفیگ پیشنهادی
چرا این کانفیگ؟
ظرفیت و پهنای باند بالای H200 در مدلهای بزرگ AI باعث میشود حافظه RAM، NVMe و شبکه پرسرعت برای جلوگیری از ایجاد گلوگاه در انتقال داده اهمیت بیشتری داشته باشند.
Large LLMHPE ProLiant DL380 Gen11
مناسب برای: Agentic AI، LLM، رندرینگ و Workstation حرفهای
کانفیگ پیشنهادی
چرا این کانفیگ؟
RTX PRO 6000 ترکیبی از AI و پردازش گرافیکی حرفهای است. این کانفیگ برای محیطهایی طراحی شده که علاوه بر مدلهای AI، به رندرینگ و پردازشهای گرافیکی سنگین نیز نیاز دارند.
AI + Pro Graphicsنکته مهم: کانفیگهای بالا نمونههای پیشنهادی هستند و انتخاب نهایی سرور باید بر اساس تعداد GPU، نوع نسخه GPU، توان مصرفی، سیستم خنککننده، محدودیتهای PCIe، نوع بار کاری و نیاز به توسعه آینده انجام شود. در سرورهای GPU محور، سازگاری کامل شاسی، رایزر، منبع تغذیه و سیستم خنککننده با GPU اهمیت ویژهای دارد.
سوالات متداول
پاسخ به سوالات مهم درباره انتخاب NVIDIA L4، L40S، H100، H200 و RTX PRO 6000 Blackwell
بهترین کارت گرافیک برای هوش مصنوعی کدام است؟
تفاوت NVIDIA L4 و L40S چیست؟
برای اجرای مدلهای هوش مصنوعی بزرگ H100 بهتر است یا H200؟
آیا NVIDIA L4 برای آموزش مدلهای هوش مصنوعی مناسب است؟
RTX PRO 6000 Blackwell برای چه کاربردهایی مناسب است؟
برای سرور HPE چه کارت گرافیکی برای هوش مصنوعی مناسب است؟
آیا تعداد بیشتر کارت گرافیک همیشه به معنی عملکرد بهتر در هوش مصنوعی است؟
برای اجرای LLM چه مقدار حافظه GPU لازم است؟
آیا RTX PRO 6000 Blackwell فقط برای هوش مصنوعی ساخته شده است؟
هنگام خرید GPU سروری برای هوش مصنوعی به چه مشخصاتی توجه کنیم؟
جمع بندی
انتخاب بهترین کارت گرافیک برای هوش مصنوعی بهطور مستقیم به نوع workload، اندازه مدل، حجم حافظه مورد نیاز، توان مصرفی، تعداد GPU و بودجه زیرساخت بستگی دارد. به همین دلیل نمیتوان یک GPU را برای تمام پروژههای هوش مصنوعی بهعنوان گزینه مناسب معرفی کرد. مدلهای NVIDIA L4، L40S، H100، H200 و RTX PRO 6000 Blackwell هرکدام برای سطح متفاوتی از پردازشهای AI، دیتاسنتری و حرفهای طراحی شدهاند.
NVIDIA L4 بیشتر برای پروژههایی مناسب است که مصرف انرژی پایین، استنتاج مدلها، پردازش ویدیو و استقرار در تعداد بالا اهمیت دارد. در مقابل، NVIDIA L40S با حافظه 48GB و توان پردازشی بالاتر، انتخابی مناسب برای ترکیب هوش مصنوعی، رندرینگ، پردازش گرافیکی و Virtualization محسوب میشود.
در سطح پردازشهای سنگینتر، NVIDIA H100 و H200 قرار میگیرند که برای آموزش و استنتاج مدلهای بزرگ هوش مصنوعی، LLMها، یادگیری عمیق و محاسبات HPC طراحی شدهاند. H200 با 141GB حافظه HBM3e و پهنای باند بسیار بالا، برای workloadهایی که به ظرفیت حافظه و انتقال سریع داده نیاز دارند، اهمیت ویژهای دارد.
از طرف دیگر، NVIDIA RTX PRO 6000 Blackwell رویکرد متفاوتی دارد و توان پردازشی بالای هوش مصنوعی را با قابلیتهای حرفهای گرافیکی ترکیب میکند. 96GB حافظه GDDR7 ECC، معماری Blackwell و پشتیبانی از کاربردهای Workstation و Server باعث شده این GPU برای پروژههایی که همزمان به AI، رندرینگ، شبیهسازی و پردازشهای حرفهای نیاز دارند، گزینهای چندمنظوره باشد.
بنابراین هنگام انتخاب GPU نباید تنها به تعداد هستههای CUDA یا قدرت پردازشی توجه کرد. ظرفیت و پهنای باند حافظه، مصرف انرژی، فرمفاکتور، سیستم خنککننده، تعداد GPU قابل نصب در سرور، PCIe و نوع workload همگی در انتخاب نهایی تأثیرگذار هستند. همچنین انتخاب GPU باید با مشخصات سرور و زیرساختی که قرار است کارت در آن نصب شود هماهنگ باشد.
در نهایت، اگر هدف شما Inference و پردازش ویدیو با مصرف انرژی پایین باشد، L4 در دسته متفاوتی قرار میگیرد؛ برای AI و پردازشهای گرافیکی حرفهای میتوان L40S را بررسی کرد؛ برای آموزش و اجرای مدلهای بزرگ در دیتاسنتر H100 و H200 مطرح هستند؛ و برای پروژههایی که ترکیبی از هوش مصنوعی، حافظه بالا، رندرینگ و پردازشهای حرفهای دارند، RTX PRO 6000 Blackwell یک گزینه قابل بررسی است.
برای انتخاب نهایی نیز بهتر است علاوه بر مشخصات GPU، کانفیگ کامل سرور HPE، منبع تغذیه، سیستم خنککننده، تعداد کارتهای مورد نیاز و نوع بار کاری بهصورت یکپارچه بررسی شود؛ زیرا عملکرد واقعی یک GPU در دیتاسنتر به هماهنگی کل زیرساخت وابسته است.
اشتراکگذاری
با استفاده از روشهای زیر میتوانید این صفحه رو به اشتراک بگذارید.